11月7日消息,据国外媒体报道,小鹏汽车联合北京大学、香港大学等7所高校研究团队正式开源具身感知基座模型 GroundingPI。这个约40亿参数的模型在34项公开感知基准、11类能力维度上以等权平均73.68分的成绩位列44个对比模型之首,超过OpenAI旗舰模型GPT-6 Astra的71.54分,研究论文、模型权重与配套代码已全部向公众开放。
与大多数直接复用通用大模型视觉底座的做法不同,GroundingPI走的是一条「感知优先」路线:训练阶段完全不使用带关节动作标签的机器人数据,只用覆盖11类能力的纯感知数据,包括通用物体检测、密集小目标定位、指代表达定位、光学字符识别(OCR)、文档版面理解、界面元素识别以及机器人空间定位等。用团队举的例子来说,当指令是「找出右边那只杯子的把手」时,模型不仅要认出正确的杯子,还要精确框出把手的位置,并以坐标点或边界框的形式输出——这正是机器人与自动驾驶系统与世界交互时最需要的基础能力。
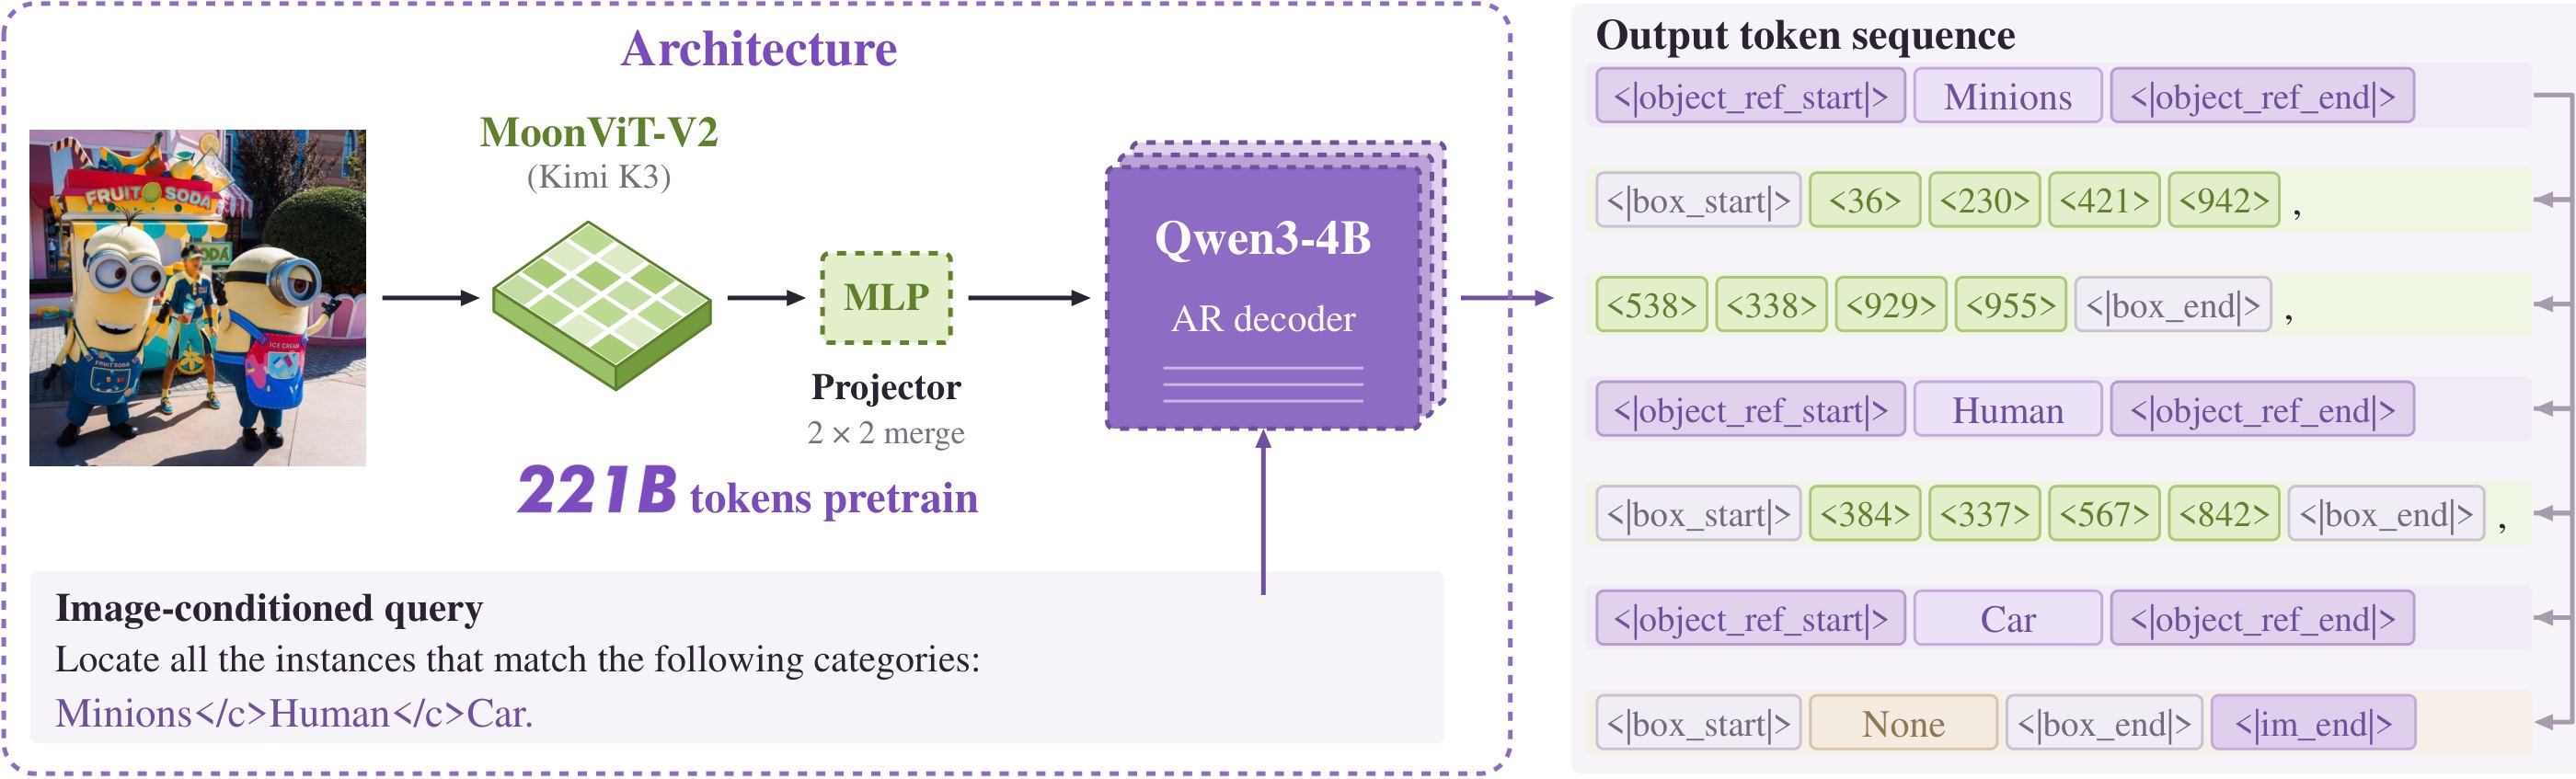
从官方项目主页公布的架构来看,GroundingPI以MoonViT-V2视觉编码器(Kimi K3同源)搭配MLP投影层,后接Qwen3-4B自回归解码器,预训练阶段消耗了221亿个token;训练配方采用多模态与空间预训练、监督微调再加GRPO强化学习的组合。模型把检测框和坐标点当作共享词表中的量化标记来生成,也就是团队所称的「视觉基元」——构成图像理解的最小积木。
成绩单方面,在11类能力等权加总的评测中,GroundingPI拿到73.68分,压过GPT-6 Astra的71.54分,11个类别中有8类排名第一,密集小目标场景优势尤其明显:Dense200基准上得分74.53,对手只有65.04。不过它并非全面碾压,在屏幕界面元素识别(ScreenSpot-Pro)一类上明显落后,得分为65.78,而Astra高达93.17。需要说明的是,这套34项基准由研究团队自建评测,目前尚无第三方独立复跑,官方也明确表示该对比只衡量感知能力,不代表通用智能或推理能力的整体优劣。
比榜单更值得关注的是下游任务验证。在RoboCasa-GR1机器人操作仿真中,以GroundingPI为视觉底座的系统只用50%的人类示教数据,就取得了28.75%的任务成功率,超过对比模型用75%数据训出的27.75%,意味着更强的感知底座可能大幅摊薄机器人训练的数据成本;在材质、背景变化等四项分布外测试中,它在RoboTwin 2.0上全部拿下第一,相对最强对比底座最高领先24.8%,全量数据成功率为66.20%。自动驾驶方向上,将GroundingPI接入nuScenes数据集作为视觉主干后,开环轨迹预测平均误差仅0.296米。
小鹏方面把GroundingPI定位为具身智能「快系统」(System 1)的感知原生底座,与负责理解规划的「慢系统」通用大模型形成互补。这套模型恰好嵌进小鹏的全栈物理AI版图:从图灵AI芯片、世界基座模型,到Robotaxi和人形机器人,感知层的开源补上了底座一环。官方同时强调,该研究仍处科研原型阶段,基于仿真与离线评测,不构成任何产品集成的承诺。值得一提的是,几乎同一时间百度也发布了Robotaxi训练框架Apollo World,中国具身智能阵营的开源竞赛正在提速。
综合来看,GroundingPI的意义不在「赢了GPT-6 Astra几分」,而在验证了一条工程路线:不必事事依赖更大的通用大模型,专用的感知预训练可以用更小的参数量、更少的动作数据,把机器人与自动驾驶的「眼睛」先练扎实。评测基准自建、结果待第三方复现、仿真与实车之间仍有距离,这些都是当前的保留项;但论文、代码、权重三件套全开源,等于把检验权交给了全球研究者和竞对。对正处在Robotaxi与人形机器人爆发前夜的中国智驾行业来说,这类感知底座的开源,可能会像当年深度学习框架开源一样,慢慢改变整个行业的成本结构。